 Andrey


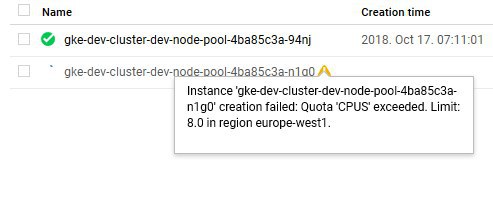
о, кажется это не autoscaler. GCP не может добавить новую ноду в instance group для пула
Andrey
попробовал вручную увеличить размер пула, и оно валится
Andrey
 Etki
 Алексей
 Mikhail [azalio]
Паппет сила! :)
Anton
я когда вижу всякое рубевое в паппете, if конструкции, erb, мне становится плохо
Mikhail [azalio]
Мне тоже. Но когда я вижу солт, меня тошнит. А ансибл кажется поделкой.
G72K
Все такие чувствительные )
 Ivan
+1 к паппету, и кстати, как там нынче с поддержкой к8с?
 Andor
Официальный модуль от пупетлабс - ниочинь
Andor
Берите модуль от Азалио :)
Mikhail [azalio]
Ггг
Andor
Мы возможно наш форк опенсорснем, но пока это не в приоритете
 Vadim
https://opensource.com/article/18/10/ansible-operators-kubernetes
G72K
А у кого кроме гуглов опенсорситть в приоритете )
Andor
У гуглов тоже не в приоритете
 𝚔𝚟𝚊𝚙𝚜
У M$
Ivan
Мы возможно наш форк опенсорснем, но пока это не в приоритете
так вы сначала опенсорсните, а потом приоритетствуйте, вам уже пуллов накидают :)
Ivan
шуткую
Andor
Сначала надо с другими проблемами разобраться

 gh
Привет, можете подсказать как быть с persistent storage на кубернетес, пытаюсь уже два месяца поднять кластер на digitalocean из 3 нод. Я не могу найти не одно нормальное решение хранения данных. Если изпользую nfs клиент, то все упираеться в сетку приватную в гигабит, это медленно для базы данных, если использую nfs provisioner из хельма, то он хранит данные только на одной ноде, и при переподнятии контейнера на другой ноде он начинает читать не с диска а по сетке с одной ноды на другую. Пробовал контейнезированные блок стораджи типо longhorn или openebs, но там вообще жесть, 1 гигабайт данных может писать 4 минуты, я писал разрабам, они сказали что у них только в планах это фиксить и вообще их решения не для продакшена. Вопрос, какой персистент сторадж исползовать при кластере из 3 нод на digitalocean? Спасибо.
Andor
а для чего тебе вообще такой сторейж?
gh
а для чего тебе вообще такой сторейж?
У меня 25 микросервисов, у каждого из них есть redis и либо mysql или mongodb. Я бы хотел чтобы если нода уйдет в офлайн, то данные остались
 Stanislav
В любом случае упрётся в сеть
gh
Т.е: Namespace1 (php,queue,redis,mongodb) Namespace2: (php,queue,redis:mysql)
𝚔𝚟𝚊𝚙𝚜
Привет, можете подсказать как быть с persistent storage на кубернетес, пытаюсь уже два месяца поднять кластер на digitalocean из 3 нод. Я не могу найти не одно нормальное решение хранения данных. Если изпользую nfs клиент, то все упираеться в сетку приватную в гигабит, это медленно для базы данных, если использую nfs provisioner из хельма, то он хранит данные только на одной ноде, и при переподнятии контейнера на другой ноде он начинает читать не с диска а по сетке с одной ноды на другую. Пробовал контейнезированные блок стораджи типо longhorn или openebs, но там вообще жесть, 1 гигабайт данных может писать 4 минуты, я писал разрабам, они сказали что у них только в планах это фиксить и вообще их решения не для продакшена. Вопрос, какой персистент сторадж исползовать при кластере из 3 нод на digitalocean? Спасибо.
У DO вроде свой провижионер есть для куба
https://stackpointcloud.com/community/tutorial/getting-started-with-digitalocean-block-storage-and-kubernetes
 Никита
У меня 25 микросервисов, у каждого из них есть redis и либо mysql или mongodb. Я бы хотел чтобы если нода уйдет в офлайн, то данные остались
Кмк, тут лучше держать несколько реплик, каждую со своим локальным стораджем, и репликацию делать средствами субд.
gh
У DO вроде свой провижионер есть для куба
https://stackpointcloud.com/community/tutorial/getting-started-with-digitalocean-block-storage-and-kubernetes
Я воевал с ними сегодня до 2 ночи, во первых первый лимит maximum 10 volumes, я выбил для себя 80, это ок, но потом я уперся в то что мах 7 volumes per droplet. Т.е. одна нода может к себе подключить 7 volumes. И все, суппорт дальше сказал, что извните мы и так подняли в этом году 5 лимит на 7
𝚔𝚟𝚊𝚙𝚜
У меня 25 микросервисов, у каждого из них есть redis и либо mysql или mongodb. Я бы хотел чтобы если нода уйдет в офлайн, то данные остались
для mysql, монги и других штук которые умеют репликацию самостоятельно, лучше использовать local-volumes
𝚔𝚟𝚊𝚙𝚜
но тут же встает вопрос с их провижионингом
Andor
А у ДО нет аналога ebs?
gh
и если я хочу себе, например, 25 на каждую ноду, то это к команде инженеров digitalocean и это на долго
gh
у DO есть digitalocean/csi-digitalocean на гитхабе, но лимит 7 volumes на дроплет, и это не изменить
𝚔𝚟𝚊𝚙𝚜
Тогда local-volumes - это лучший выбор. Вам будет достаточно нагенерить по 25 PV на ноду, потом куб уже будет раздавать их на каждый PVC
gh
Последнее что я решил, это поднять 25 кластеров монги или mysql, и исползовать Bind mount local directory from node
Andor
оператором?
gh
Так, я забыл сказать, я использую ранчер 2.1. я могу не до конца вас понимать. Т.е. вы предлагаете просто сделать маунт в локальную директорию самой ноды ? т.е. без persistence ?
𝚔𝚟𝚊𝚙𝚜
https://kubernetes.io/blog/2018/04/13/local-persistent-volumes-beta/
gh
https://kubernetes.io/blog/2018/04/13/local-persistent-volumes-beta/
Спасибо, такого я еще не видел, сейчас почитаю
 V
ребят подскажите, создал secret SSL с Сертификатом, tls.key и tls.crt внутри tls.crt вся цепочка сертификатов.
Но nginx-ingress продолжает перезагружает конфиг где-то каждую минуту и в логах он постоянно добавляет и удаляет trusted-certificate
𝚔𝚟𝚊𝚙𝚜
Спасибо, такого я еще не видел, сейчас почитаю
вот тут есть provisioner для local-волумов
https://github.com/kubernetes-incubator/external-storage/tree/master/local-volume/provisioner
gh
похоже это то что надо, спасибо
gh
Я так понимаю что при этом варианте базы данных всегда должны быть кластерами с репликами? иначе если контейнер упдает на ноде1 и поднимится на ноде2 то там данных базы уже не будет, правильно ?
Terry
Я так понимаю что при этом варианте базы данных всегда должны быть кластерами с репликами? иначе если контейнер упдает на ноде1 и поднимится на ноде2 то там данных базы уже не будет, правильно ?
вот тут надо почитать об кластерах mysql, mongodb
Andor
уже сказали почему он ниочинь в данном кейсе
gh
там еще с ним проблема, что, если ты привысил лимит volume, то драйвер в тихую атакует своим токеном диджитол оушн, лимит у токена 5000 запросов в час. Лимит достигаеться и все, В случае если у тебя будет 3 ноды, одна упадет, драйвер попытаеться перекинуть volumes на другую ноду, достигнет лимита в 7 volumes на ноду и убьет еще и токен. в Итоге останешся с кластером без volumes и с токеном который заработает только через час...
Andor
огненно
Salem
хехе
𝚔𝚟𝚊𝚙𝚜
уходи с rancher, используй kubeadm
𝚔𝚟𝚊𝚙𝚜
потом если надо будет отдельно его подтянешь
 Даня
подскажите пожалуйста, как лучше привязать iam роль к контейнеру dind (он выполняет функцию сборщика имейджей и пушит их в ecr)
Даня
при помощи kube2iam?
Anton
Товарищи а кто как чистит старые контейнеры на нодах? system prune не все подчищает
 Artyom
Может проще старые репликасеты поудалять?
 Rainbow
удалять и заводить новые ноды, заодно тестить,что все стабильно.
 bebebe
Удалять старые baremetal и заводить новые
Artyom
вместе с репликасетом удаляется image
 Denis
Товарищи а кто как чистит старые контейнеры на нодах? system prune не все подчищает
https://github.com/onfido/k8s-cleanup
Anton
Удалять старые baremetal и заводить новые
класная идея, заодно по новой разворачиватьь все что за кластером? типа ceph? =)
Denis
А kubelet сам не умеет подчищать мусор и старые имейджы? Давно интересовался этим вопросом
bebebe
класная идея, заодно по новой разворачиватьь все что за кластером? типа ceph? =)
А вы руками что-ли делаете?
Anton
темболее если дропнуть ноду у цефа веселенький ребаланс
bebebe
ну вы выведите worker, но ноду с osd не тушите, добавьте новую
Vadim
А kubelet сам не умеет подчищать мусор и старые имейджы? Давно интересовался этим вопросом
https://kubernetes.io/docs/concepts/cluster-administration/kubelet-garbage-collection/
Denis
Anton
ну вы выведите worker, но ноду с osd не тушите, добавьте новую
Какой то сложный путь чтобы почистить имэйджы =)
bebebe
Какой то сложный путь чтобы почистить имэйджы =)
зато экспертиза появится, если что-то в будущем пойдет не так 😉