Никита


Велкам!)
 Grisha
Ребзя, привет! Подскажите, можно ли при rolling update в deployments указать pre_stop хук?
 Denis
Кароч на сертификат прометеус может в двух местах ругаться - во время процесса дискавери, и в момент похода на задискаверенные эндпоинты за метриками.
Failed to list *v1.Pod
Failed to list *v1.Endpoints
Failed to list *v1.Service
Denis
Grisha
spec:
containers:
- image: nginx:1.9.4
imagePullPolicy: IfNotPresent
lifecycle:
preStop:
exec:
command:
- sleep 60
Запилил вот так, но когда запускаю апдейт например релиза nginx , контейнер перезагружается сразу же
Никита
Куда копать или с чем это связанно?
tls_config есть и в секции kubernetes_sd_configs, там попробуй указать свой ca_file.
Судя по тому, что он не может ничего листить - проблема ещё и с RBAC, добавь туда же bearer_token аккаунта с правами на листинг нужных ресурсов.
Никита
С дивана решение выглядит так)
Никита
https://prometheus.io/docs/prometheus/latest/configuration/configuration/#kubernetes_sd_config
Denis
tls_config есть и в секции kubernetes_sd_configs, там попробуй указать свой ca_file.
Судя по тому, что он не может ничего листить - проблема ещё и с RBAC, добавь туда же bearer_token аккаунта с правами на листинг нужных ресурсов.
Сейчас прометей работает в кластере под этим самым сервисным аккаунтом и проблем нет.
Никита
А, я думал, вопрос про поход снаружи.
Denis
А, я думал, вопрос про поход снаружи.
Я его переношу из кластера, наружу. Сейчас вот думаю как сделать.
scrape_configs:
- job_name: 'kubernetes-apiservers'
kubernetes_sd_configs:
- role: endpoints
api_server: https://10.10.54.88:6443
scheme: https
tls_config:
ca_file: /etc/prometheus/ca.crt
bearer_token_file: /etc/prometheus/token
relabel_configs:
- source_labels: [__meta_kubernetes_namespace, __meta_kubernetes_service_name, __meta_kubernetes_endpoint_port_name]
action: keep
regex: default;kubernetes;https
Так не работает. x509: certificate signed by unknown authority выдает
Denis
Я его переношу из кластера, наружу. Сейчас вот думаю как сделать.
scrape_configs:
- job_name: 'kubernetes-apiservers'
kubernetes_sd_configs:
- role: endpoints
api_server: https://10.10.54.88:6443
scheme: https
tls_config:
ca_file: /etc/prometheus/ca.crt
bearer_token_file: /etc/prometheus/token
relabel_configs:
- source_labels: [__meta_kubernetes_namespace, __meta_kubernetes_service_name, __meta_kubernetes_endpoint_port_name]
action: keep
regex: default;kubernetes;https
Так не работает. x509: certificate signed by unknown authority выдает
Вот тут подобная беда:
https://stackoverflow.com/questions/50587087/prometheus-outside-kubernetes-cluster
 sbog
Доброго вечера, коллеги. Есть инсталляция k8s, 8 нод под workload, nginx ingress, сервис за ним. Перед k8s внешний балансер. Идем в сервис за данными - тот отдает их за 2мс вне зависимости от количества реквестов (по сути, если идешь с однотипным запросом, он один раз берет данные из базы, а остальное время отдает из кэша). Идем в k8s - держит 550 rps, дальше начинает терять пакеты, чем дальше, тем больше. На балансере нагрузка около 40% по CPU при этом (разворачиваем https), на сервисе нагрузка минимальна, на ингрессе, судя по всему, теряем запросы, но нагрузка на нем тоже невысокая. Стандартная инсталляция прометеуса несильно помогает понять, в чем дело. Есть предположения, куда и как копать, если есть желание получить на сервисе, скажем, 10k rps?
Никита
scrape_configs:
- job_name: 'kubernetes-apiservers'
kubernetes_sd_configs:
- role: endpoints
api_server: https://10.10.54.88:6443
tls_config:
ca_file: /etc/prometheus/ca.crt
bearer_token_file: /etc/prometheus/token
scheme: https
tls_config:
ca_file: /etc/prometheus/ca.crt
Никита
См. секцию kubernetes_sd_configs
Никита
Мне кажется, проблема в этом.
Denis
scrape_configs:
- job_name: 'kubernetes-apiservers'
kubernetes_sd_configs:
- role: endpoints
api_server: https://10.10.54.88:6443
tls_config:
ca_file: /etc/prometheus/ca.crt
bearer_token_file: /etc/prometheus/token
scheme: https
tls_config:
ca_file: /etc/prometheus/ca.crt
Помоему так пробовал тоже. Щас проверим. Я уже просто запутался.
 Andor
у тебя даже таргеты не находятся из кубе-апи?
Denis
scrape_configs:
- job_name: 'kubernetes-apiservers'
kubernetes_sd_configs:
- role: endpoints
api_server: https://10.10.54.88:6443
tls_config:
ca_file: /etc/prometheus/ca.crt
bearer_token_file: /etc/prometheus/token
scheme: https
tls_config:
ca_file: /etc/prometheus/ca.crt
Да, я пробовал так, и после этого ошибка ушла. Но прометей так и не пошел собирать в кластер метрики. Все пусто в логах его
Denis
у тебя даже таргеты не находятся из кубе-апи?
Не совсем понял замечание. Вот всю базу по настройке брал от сюда.
https://github.com/prometheus/prometheus/blob/master/documentation/examples/prometheus-kubernetes.yml
Никита
Да, я пробовал так, и после этого ошибка ушла. Но прометей так и не пошел собирать в кластер метрики. Все пусто в логах его
Он в Service Discovery должен показать эндпоинты. Если он их задискаверил, но не получил метрики - он напишет, что за ошибка.
Никита
В смысле, в веб-интерфейсе.
Denis
В смысле, в веб-интерфейсе.
В интерфейсе нет метрик. Все дефолтные. Как будто он ничего не делает.
Никита
В интерфейсе нет метрик. Все дефолтные. Как будто он ничего не делает.
Там есть отдельный пункт "Service Discovery", в меню в выпадающем списке.
Denis
Там есть отдельный пункт "Service Discovery", в меню в выпадающем списке.
Спасибо за совет. Да действительно они есть там.
Andor
Denis
Даже меньше
Никита
Ага, если ендпоинты задискаверились, то секция kubernetes_sd_configs правильная) Дальше надо смотреть, почему метрики не приезжают.
Andor
ну если в таргетах есть хоть что-то, значит кубе-апи работает
Andor
если оно всё красное - с этим уже надо разбираться отдельно
Denis
Ага, если ендпоинты задискаверились, то секция kubernetes_sd_configs правильная) Дальше надо смотреть, почему метрики не приезжают.
А как можно продебажить это? Я правильно понимаю что прометей ломится в kube-api, потом чекает все сервисы, эндпойнты, и поды. Когда находит экспортеры, то забирает с них метрики?
Andor
зависит от настроек, может что-то собирать, а что-то скипать
Никита
В твоём конфиге есть - role: endpoints, значит, он будет собирать только эндпоинты.
sbog
И технически балансер очень близко расположен к кластеру, там TTL<1ms
 Stas
Да, каждой нодой просто
я бы начал с того что заэкспоузил сервис нод портом и потестил, после этого когда стало юы точно понятно что это нджинкс пошел бы читать статьи
sbog
Норм идея, пасиб
Никита
В твоём конфиге есть - role: endpoints, значит, он будет собирать только эндпоинты.
endpoint - это такая сущность кубернетеса. Обычно их регистрирует сервис, когда выбирает необходимые ему поды (или как-то так).
Stas
Норм идея, пасиб
после этого я бы начал с этого https://danielfm.me/posts/painless-nginx-ingress.html
sbog
Угу, тоже вот нашел это. Попробую сейчас сервис выставить нодпортом
 Hello
какая допустимая задержка для федерализации не больше 50мс?
 Dmitry
гайс, а кому-то прилетал инвайт на k8s от digitalocean ?
Andor
летом прилетал
 Serega
Доброго вечера, коллеги. Есть инсталляция k8s, 8 нод под workload, nginx ingress, сервис за ним. Перед k8s внешний балансер. Идем в сервис за данными - тот отдает их за 2мс вне зависимости от количества реквестов (по сути, если идешь с однотипным запросом, он один раз берет данные из базы, а остальное время отдает из кэша). Идем в k8s - держит 550 rps, дальше начинает терять пакеты, чем дальше, тем больше. На балансере нагрузка около 40% по CPU при этом (разворачиваем https), на сервисе нагрузка минимальна, на ингрессе, судя по всему, теряем запросы, но нагрузка на нем тоже невысокая. Стандартная инсталляция прометеуса несильно помогает понять, в чем дело. Есть предположения, куда и как копать, если есть желание получить на сервисе, скажем, 10k rps?
нжинкс-ингресс в дефолтной конфигруации тысячи запросов не напрягаясь пережовывает. Я бы начал с того, что снимал бы метрики с кластера и ингресс контролера (особенно удобно это делать с последними версиями nginx-ingress где даже графана дашборда из коробки вполне вменяемая, там используется lua вместо vts для метрик). Далее можно делать лоадтест как самого нжинкса (какой-нибудь статус ендпоинт дергать) так и лоадтест “эхо” сервиса, после этого лоадтесты уже рабочего сервиса.
Ну и для лоад тестов брать нормальные приблуды, например, wrk,tank,vegeta.
Grisha
Может сегодня повезет, ребзя подскажите, как при rolling update в deployments сделать так чтобы перед обновлением пода он дождался когда все службы внутри пода заерщаться?
Dmytro
EFS ещё амазоновский можно
Dmytro
 Dmytro
Кто-то вроде тоже собирался, дошёл?
Terry
оо забыл
Terry
а стрим уже начался
 V
Может сегодня повезет, ребзя подскажите, как при rolling update в deployments сделать так чтобы перед обновлением пода он дождался когда все службы внутри пода заерщаться?
поставь таймаут большой для выключения поды что-то типа 3600. он его выведет из лоад балансинга но будет ждать пока он сам выйдет.
Grisha
поставь таймаут большой для выключения поды что-то типа 3600. он его выведет из лоад балансинга но будет ждать пока он сам выйдет.
я так и подумал, но стримы бывают долгоиграющие и по 2-3 часа
Grisha
тут сложность еще в том что я не управляю балансигом им занимается другой процесс nodejs
Grisha
есть CC - command center у ноды, которые рулит трафом
 Vadim
Может сегодня повезет, ребзя подскажите, как при rolling update в deployments сделать так чтобы перед обновлением пода он дождался когда все службы внутри пода заерщаться?
K8s ничего не знает про службы внутри контейнера
V
я имею ввиду балансинг на уровне service
Andor
А Service занимается балансировкой?
Dmitry
А как можно продебажить это? Я правильно понимаю что прометей ломится в kube-api, потом чекает все сервисы, эндпойнты, и поды. Когда находит экспортеры, то забирает с них метрики?
Пром из API получает внутренние IP и аннотации куда стучаться за метриками (если нестандартные порты и URL), а потом пытается в них сходить. Отсюда метод проверки - с хоста прома ты можешь получить метрики с подов (в первую очередь маршрутизация внутренних ip)
Denis
Пром из API получает внутренние IP и аннотации куда стучаться за метриками (если нестандартные порты и URL), а потом пытается в них сходить. Отсюда метод проверки - с хоста прома ты можешь получить метрики с подов (в первую очередь маршрутизация внутренних ip)
Да это я уже понял. Уже некоторые ошибки исправил.
 bebebe
Denis
 Denis
Может кто подскажет в чем может быть проблема?
Denis
kubectl describe clusterrole -n prometheus-monitoring prometheus
PolicyRule:
Resources Non-Resource URLs Resource Names Verbs
--------- ----------------- -------------- -----
endpoints [] [] [get list watch]
nodes/proxy [] [] [get list watch]
nodes [] [] [get list watch]
pods [] [] [get list watch]
services [] [] [get list watch]
ingresses.extensions [] [] [get list watch]
[/metrics] [] [get]
Denis
Вроде как с RBAC все в порядке.
Dmitry
Сделай копию текущих и дай полные
Denis
Сделай копию текущих и дай полные
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
name: prometheus
rules:
- apiGroups:
- ""
resources:
- nodes
- nodes/proxy
- services
- endpoints
- pods
verbs:
- get
- list
- watch
- apiGroups:
- extensions
resources:
- ingresses
verbs:
- get
- list
- watch
- nonResourceURLs:
- /metrics
verbs:
- get
Dmytro
Вроде бы не было в этом чате https://kubedex.com/google-gke-vs-microsoft-aks-vs-amazon-eks/
sbog
Вы сначала разберитесь где пакеты теряются - в ингрессе или в оверлей сети
Я бы послушал, как фланель теряет пакеты, да
bebebe
Я бы послушал, как фланель теряет пакеты, да
У вас должен быть отменный слух. Фланель теряет пакеты ОЧЕНЬ тихо
sbog
Как она вообще их теряет, если технически она является просто набором iptables правил и Veth пар?
sbog
В моей практике обычный бридж не теряет в принципе ничего. Он нагрузку может колоссальную держать. А у меня тут 550 rps всего-то
Dmytro
вы потом расскажите чем мир дышит
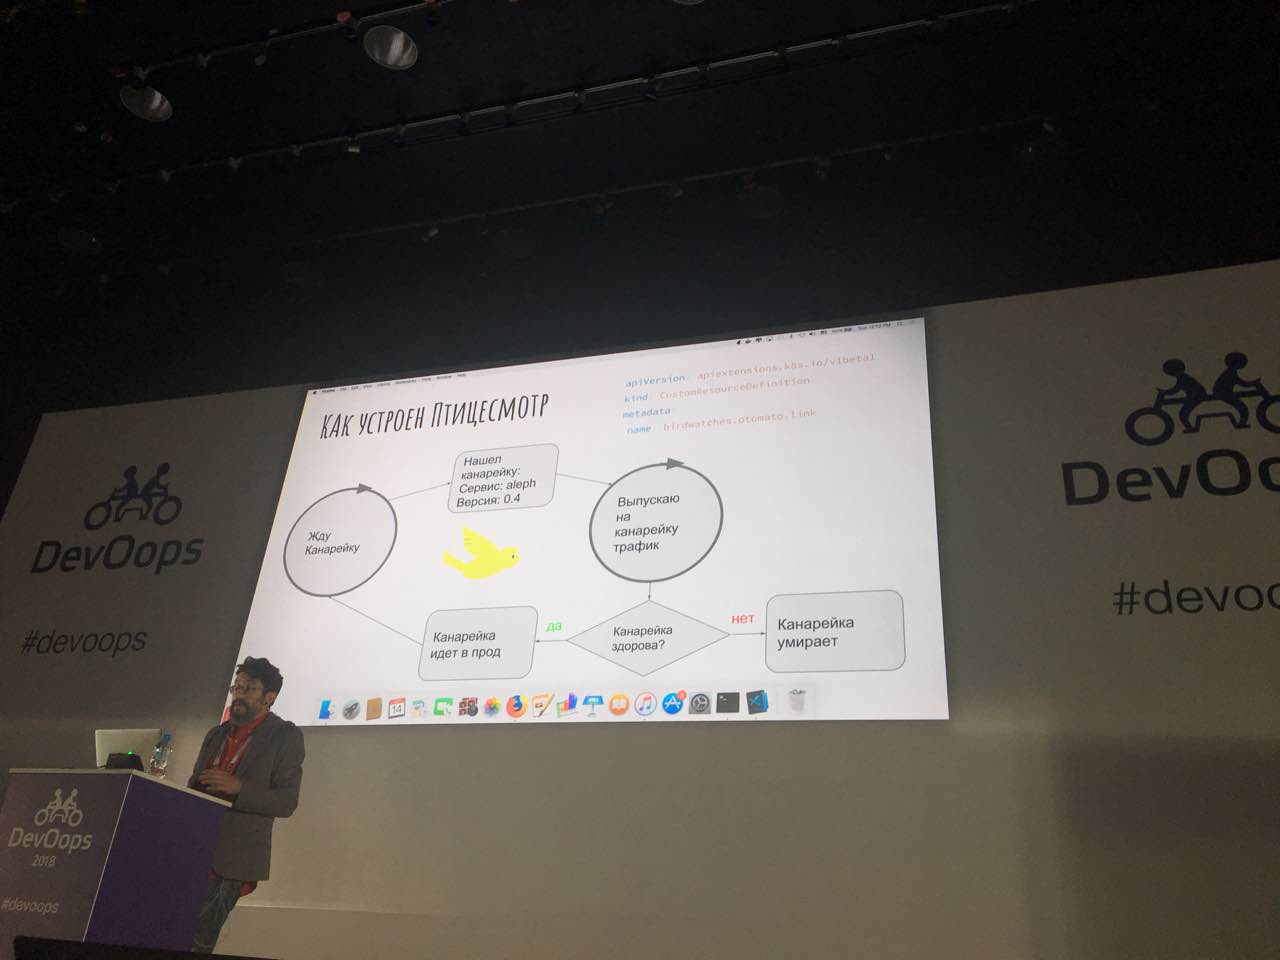
Интересный доклад по istio, показали тулзу birdwatch для автоматизации canary deployments
Dmytro